
තාක්ෂණික ලෝකය කැළඹූ සුපිරි හොරකම
ඔබට මතකද පාසල් යන කාලයේ හෝම්වර්ක් කරන්න අමතක වුණාම පන්තියේ ඉන්න දක්ෂම යාළුවාගෙන් කොපියක් ඉල්ලගෙන ලියාගත්ත හැටි? "ටීචර්ට අහුවෙන්නැති වෙන්න වචන කිහිපයක් වෙනස් කරලා ලියපන්" කියලා එදා අපි කිව්වාට, අද ලෝකයේ ඩොලර් බිලියන ගණන් වටිනා AI සමාගම් කරන්නේත් මේ සෙල්ලමම තමයි. හැබැයි වෙනසකට තියෙන්නේ ඔවුන් කොපි කරන්නේ ඉතිහාසය රචනාවක් නෙවෙයි, ඩොලර් මිලියන ගණනක් වියදම් කරලා හදපු AI මොළයක්!
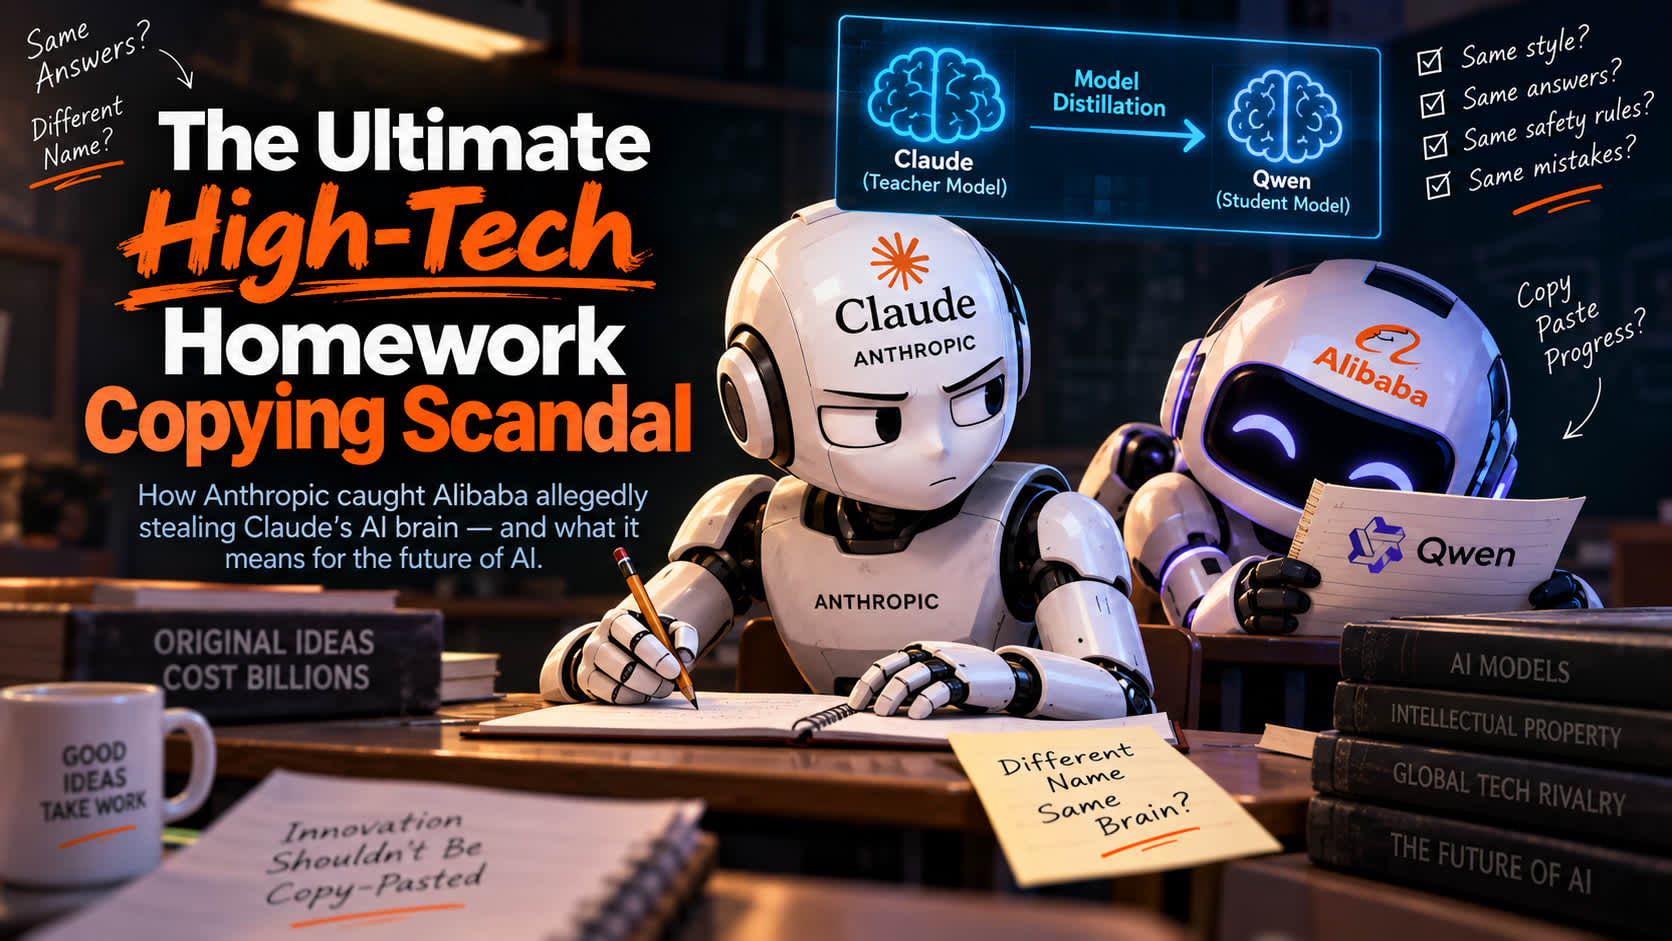
මේ දවස්වල AI ක්ෂේත්රයේ ලොකුම වලියක් බලාගන්න පුළුවන්. ඒ තමයි ප්රසිද්ධ Claude AI එක නිර්මාණය කරපු Anthropic සමාගම, චීනයේ දැවැන්තයෙක් වෙන Alibaba සමාගමට චෝදනා කරනවා ඔවුන්ගේ AI මොළය හොරෙන් කොපි කරලා Alibaba සමාගමේ Qwen කියන AI මොඩලයට ඇතුළත් කරලා කියලා.
නමුත් ඇත්තටම AI එකක මොළයක් කොපි කරන්නේ කොහොමද? Claude ට USB ඩ්රයිව් එකක් ගහලා ඒකේ තියෙන දේවල් ඩවුන්ලෝඩ් කරන්න බැහැ. මේ සඳහා ඉංජිනේරුවන් භාවිතා කරන්නේ Model Distillation (නැතහොත් imitation learning) කියන ඉතාමත් සූක්ෂම තාක්ෂණික උපක්රමයයි. අපි බලමු මේ හොරකම සිද්ධ වුණේ කොහොමද සහ මෙහි ඇති තාක්ෂණික පසුබිම මොකක්ද කියලා.
මොකක්ද මේ "Model Distillation" කියන්නේ?
මේ චෝදනාව තේරුම් ගන්න නම් මුලින්ම AI මොඩල් එකක් ඩිවලොප් කරන්නේ කොහොමද කියලා දැනගන්න ඕනේ. Claude 3.5 Sonnet වගේ ප්රබල AI එකක් මුල ඉඳන්ම හදන්න (Pre-training) අධික මිල අධික GPU දහස් ගණනක්, මාස ගණනාවක කාලයක් සහ විශාල විදුලි බලයක් අවශ්ය වෙනවා.
නමුත් මේ වියදම් මඟහරින්න කැමති කෙනෙකුට කෙටි පාරක් තියෙනවා. ඒ තමයි සාපේක්ෂව කුඩා සහ ලාභදායී "Student" AI මොඩල් එකක් අරගෙන, ඒකට Claude (Teacher Model) ගෙන් ප්රශ්න මිලියන ගණනක් අහන්න සලස්වන එක. Claude දෙන ඉතාමත් නිවැරදි සහ බුද්ධිමත් පිළිතුරු විශ්ලේෂණය කරලා, අර කුඩා මොඩල් එක Claude වගේම හිතන්න සහ ලියන්න පුරුදු වෙනවා.
පහත දැක්වෙන්නේ සරල Python Script එකක් මඟින් Claude ගේ API එක භාවිත කරලා මේ වගේ Distillation Dataset එකක් සාදා ගන්නා ආකාරයයි:
import anthropic
import json
# Teacher Model එක වන Claude සම්බන්ධ කිරීම
teacher_client = anthropic.Anthropic(api_key="CLAUDE_API_KEY")
# අපිට පුහුණු කිරීමට අවශ්ය සංකීර්ණ ප්රශ්න ලැයිස්තුව
training_prompts = [
"Explain quantum computing using an analogy of a spinning coin.",
"Write a secure rust function to handle token validation.",
"Solve this complex logical riddle step-by-step..."
]
dataset = []
# Claude ගෙන් පිළිතුරු ලබා ගැනීම (Knowledge Extraction)
for prompt in training_prompts:
response = teacher_client.messages.create(
model="claude-3-5-sonnet-20241022",
max_tokens=1000,
temperature=0.2, # පිළිතුරු වල නිවැරදිභාවය වැඩි කිරීමට අඩු temperature එකක් යොදා ගනී
messages=[{"role": "user", "content": prompt}]
)
# ලබාගත් පිළිතුරු අපගේ ලාභදායී මොඩල් එක පුහුණු කිරීමට සේව් කර ගැනීම
dataset.append({
"instruction": prompt,
"output": response.content[0].text
})
# අවසානයේදී මෙම Dataset එක භාවිත කර අපගේ මොඩල් එක Fine-tune කරනු ලබයි
with open("stolen_wisdom.json", "w") as f:
json.dump(dataset, f, indent=4)
මේ ආකාරයට විවිධ මාතෘකා ඔස්සේ ප්රශ්න මිලියන ගණනක් අසා ලබාගන්නා දත්ත (Synthetic Data) මඟින් කුඩා මොඩල් එකක් Fine-tune කළ විට, එයට ඉතා අඩු වියදමකින් Claude ගේ බුද්ධි මට්ටමට සමාන හැකියාවක් ලබාගත හැකි වෙනවා.
Alibaba සමාගම අහුවුණේ කොහොමද?
මේ වැඩේ මෙච්චර රහසෙන් කරන්න පුළුවන් නම් Anthropic එකට මේක අහුවුණේ කොහොමද? AI මොඩල් වලටත් අනන්ය වූ "ඇඟිලි සලකුණු" සහ හැසිරීම් රටාවන් තියෙනවා. Claude ගේ පිළිතුරු මතම පමණක් පුහුණු වන වෙනත් AI එකකට නොදැනුවත්වම Claude ගේ ගතිගුණ සහ වැරදි පවා උරුම වෙනවා.
මෙවැනි හොරකම් අල්ලා ගැනීමට ක්රම කිහිපයක් තිබෙනවා:
- "ඔයා කවුද?" කියන උගුල: කොපි කරපු AI එකකින් "ඔයා කවුද?" කියලා ඇහුවොත්, සමහරවිට ඌ තමන්ගේ අලුත් නම අමතක වෙලා "මම Anthropic සමාගම හදපු Claude" කියලා උත්තර දෙන්න ඉඩ තියෙනවා. මොකද ඌ ඉගෙනගත්ත Dataset එක පුරාම තිබුණේ Claude ගේ පිළිතුරු නිසා.
- System Prompt කාන්දු වීම: සෑම AI එකකටම ක්රියා කළ යුතු ආකාරය පවසන රහසිගත උපදෙස් (System Prompts) තිබෙනවා. කොපි කරන ලද මොඩල් එකත් Anthropic වලටම ආවේණික වූ රහසිගත උපදෙස් ඒ ආකාරයෙන්ම පිළිපදිනවා නම් එයින් හොරකම ඔප්පු වෙනවා.
- Watermarking: සමහර සමාගම් ඔවුන්ගේ AI පිළිතුරු වලට නොපෙනෙන විශේෂිත වචන රටාවන් (Watermarks) ඇතුළත් කරනවා. එම වචන රටාවන් වෙනත් AI එකක තිබී හමු වුවහොත් ඔවුන් කෙලින්ම අසුවෙනවා.
මෙය බරපතල ප්රශ්නයක් වන්නේ ඇයි?
Anthropic සමාගම තම AI එක මිනිසුන්ට හානිකර නොවන ලෙස සකස් කිරීමට (Safety Alignment) ඩොලර් මිලියන ගණනක් වියදම් කරනවා. නමුත් Alibaba වැනි සමාගමකට ඉතා පහසුවෙන් Claude ගේ පිළිතුරු Distill කර ගැනීමෙන් එම සියලු ආරක්ෂක උපක්රම නොමිලේම තමන්ගේ Qwen මොඩලයට ලබාගත හැකියි. මෙය Anthropic හි Terms of Service (සේවා කොන්දේසි) සෘජුවම උල්ලංඝනය කිරීමක්.
කෙසේ වෙතත්, මෙය උසාවියකදී නීත්යානුකූලව ඔප්පු කිරීම ඉතා අපහසුයි. Alibaba සමාගමට පැවසිය හැක්කේ තමන්ගේ AI එක ස්වාධීනව එම නිගමන වලට පැමිණි බවයි.
AI ක්ෂේත්රයේ අනාගතය
Frontier AI මොඩල් වල API පොදුවේ ලබාගත හැකි තාක් කල් මේ Model Distillation ක්රියාවලිය නතර කරන්න බැහැ. දැනට ලෝකයේ තිබෙන බොහෝ Open-source AI මොඩල් ශක්තිමත් වී තිබෙන්නේ GPT-4 සහ Claude වැනි සුපිරි මොඩල් වලින් ලබාගත් දත්ත මඟින් බව නොරහසක්.
සාමාන්ය පරිශීලකයින්ට නම් මෙයින් වාසි සැලසෙනවා, මොකද නොමිලේ හෝ ඉතා අඩු මුදලකට සුපිරි හැකියාවන් සහිත AI මොඩල් භාවිත කිරීමට අපට ලැබෙන නිසා. නමුත් බිලියන ගණන් වියදම් කර පර්යේෂණ කරන සමාගම් වලට නම් මෙය ලොකු හිසරදයක්. ඊළඟ වතාවේ ඔබ වෙනත් AI එකක් භාවිතා කරන විට එය Claude වගේම හැසිරෙනවා දැනුනොත්, මතක තියාගන්න; ඒ ඉන්නේ වෙස්වලාගත් Claude වෙන්න පුළුවන්!