
Introduction
Generative Artificial Intelligence (AI) සහ Large Language Models (LLMs) ක්ෂේත්රය තුල, Prompt එකක් යනු සරලවම පරිශීලකයෙකු විසින් ලබාදෙන Text Input එකක් ලෙස හැඳින්විය හැක. නමුත් Computer Science දෘෂ්ටිකෝණයකින් බැලූ විට, Prompt එකක් යනු model එකෙහි autoregressive token generation ක්රියාවලියේ probability distribution එක පාලනය කරනු ලබන input sequence of tokens එකකි. නිවැරදි සහ ගුණාත්මක Prompt එකක් නිර්මාණය කරන්නේ කෙසේද යන්න තේරුම් ගැනීමට නම්, Transformer architectures, attention mechanisms සහ latent space ක්රියාකාරීත්වය පිළිබඳව තාක්ෂණික අවබෝධයක් තිබීම අත්යවශ්ය වේ.
LLMs මගින් ඔබ ලබාදෙන Input එක Process කරන ආකාරය
සාර්ථක ලෙස prompts නිර්මාණය කිරීම සඳහා LLM එකක් ක්රියා කරන ආකාරය පිළිබඳ අවබෝධයක් තිබිය යුතුය. ඔබ Prompt එකක් ලබාදුන් විට, model එක එය මිනිසෙකු මෙන් කියවන්නේ නැත. ඒ වෙනුවට එය පහත පියවර හරහා ක්රියාත්මක වේ:
- Tokenization: ලබාදෙන raw text එක කුඩා කොටස්වලට (tokens) වෙන් කර, කලින් අර්ථ දක්වන ලද vocabulary එකක් මත පදනම්ව numerical IDs බවට පත් කරයි.
- Embedding: මෙම token IDs, high-dimensional vectors බවට පරිවර්තනය කර continuous vector space (latent space) එකක් තුල ස්ථානගත කරයි.
- Attention Mechanism: Transformer model එක මගින් self-attention ක්රියාවලිය සිදු කරයි. මෙහිදී sequence එකෙහි ඇති සෑම token එකක් අතරම පවතින ගණිතමය සම්බන්ධතාවය ගණනය කර, එක් එක් වචනයට ලැබිය යුතු බර තැබීම (weight) තීරණය කරයි.
- Probability Distribution: Attention weights මත පදනම්ව, sequence එකට ඊළඟට පැමිණිය හැකි වඩාත්ම ගැලපෙන token එකෙහි probability distribution එක ගණනය කර, stop token එකක් හමුවන තෙක් මෙම ක්රියාවලිය නැවත නැවත සිදු කරයි.
හොඳ Prompt එකක් මගින් මෙම ගණිතමය අවකාශය (mathematical space) තුල ඇති අපැහැදිලි බව අවම කර, අදාළ task එකට අවශ්ය නිවැරදි දැනුම සහ ශෛලිය වෙත model එකෙහි attention එක සීමා කරයි.
Production-Grade Prompt එකක අඩංගු විය යුතු ප්රධාන කොටස්
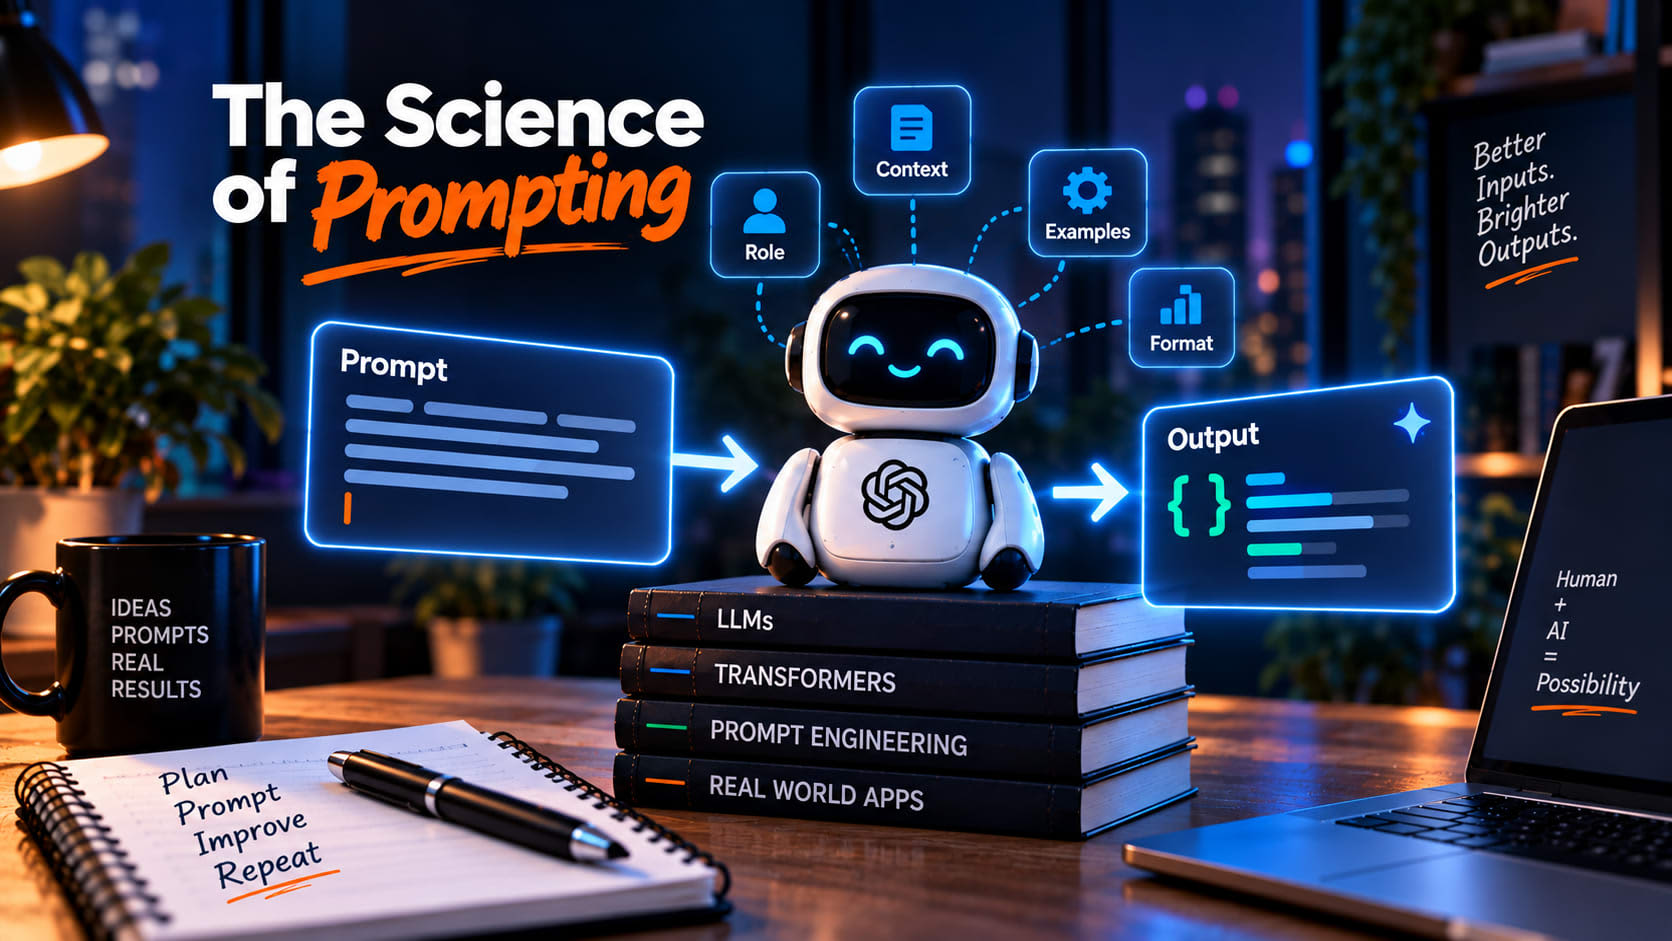
සරල ප්රශ්නයක් ඇතුලත් prompt එකක් වෙනුවට, deterministic සහ උසස් තත්ත්වයේ ප්රතිදානයන් ලබා ගැනීම සඳහා production-grade prompt එකක ප්රධාන කොටස් හතරක් අඩංගු විය යුතුය:
1. System Instructions (Persona සහ Role)
මගින් model එක ක්රියාත්මක විය යුතු latent space සීමාවන් තීරණය කරයි. නිශ්චිත persona එකක් ලබාදීම මගින්, training data අතරින් වඩාත්ම ගැලපෙන දත්ත කොටස තෝරා ගැනීමට model එකට මග පෙන්වයි.
# Good System Instruction
You are a senior systems engineer specializing in Linux kernel optimization. Respond only with technically precise, low-level explanations.
2. Context සහ Grounding Data
LLMs තම weights තුල ඇති මතකය (parametric memory) මත පමණක් විශ්වාසය තබා පිළිතුරු සැපයීමේදී වැරදි තොරතුරු (hallucination) ලබාදීමේ ප්රවණතාවක් ඇත. නිවැරදි context හෝ grounding data ලබාදීම මගින් model එක තහවුරු කරන ලද දත්ත මත පමණක් ක්රියාත්මක වන බව සහතික කල හැක. මෙය Retrieval-Augmented Generation (RAG) හි පදනම වේ.
# Grounding Context
Using only the provided system metrics below, diagnose the performance bottleneck:
[Metrics: CPU utilization 98%, I/O wait 45%, Memory usage 40%]
3. Input Data (The Payload)
මෙය process කල යුතු සැබෑ දත්ත (variable data) වේ. Input payload එක instructions වලින් වෙන් කර තැබීම මගින් prompt injection සහ parsing errors වළක්වා ගත හැක.
4. Output Formatting සහ Constraints
LLM outputs මෘදුකාංග පද්ධති (software pipelines) තුල භාවිතයට ගැනීමට නම්, ලැබෙන response එක structured එකක් විය යුතුය. JSON schemas හෝ length limits වැනි constraints මෙහිදී අර්ථ දැක්විය හැක.
# Output Constraints
Return the output strictly as a valid JSON object matching this schema:
{
  "status": "string",
  "error_code": "integer"
}
Do not include any markdown formatting, preambles, or postscripts.
Advanced Prompting ක්රමවේදයන්
සරල zero-shot prompting (සෘජුව ප්රශ්නයක් ඇසීම) මගින් අපේක්ෂිත ප්රතිඵල නොලැබෙන විට, වඩාත් උසස් ක්රමවේදයන් භාවිතා කල හැක.
Few-Shot Prompting
මෙහිදී LLMs සතු in-context learning හැකියාව භාවිතා කරයි. Prompt එක තුල input-output උදාහරණ (exemplars) කිහිපයක් ලබාදීම මගින්, model එක fine-tune කිරීමකින් තොරව අවශ්ය logic එක සහ formatting රටාව පෙන්වා දිය හැක.
Input: User cannot log in. Error code 403.
Output: Category: Authentication | Severity: High | Action: Verify OAuth token.

Input: Page loads slowly. Response time 5000ms.
Output: Category: Performance | Severity: Medium | Action: Check database query latency.

Input: API returns 502 Bad Gateway.
Output:
Chain-of-Thought (CoT) Prompting
සංකීර්ණ logical, mathematical, හෝ reasoning tasks සඳහා, අවසාන පිළිතුර ලබාදීමට පෙර අතරමැදි පියවරයන් (reasoning steps) generate කිරීමට model එකට බල කිරීම මගින් ප්රතිඵලවල නිවැරදිභාවය බෙහෙවින් වැඩි කල හැක. මෙය Chain-of-Thought prompting ලෙස හැඳින්වේ.
Problem: A server rack has 4 nodes. Each node has 2 CPUs. Each CPU has 16 cores. We need to allocate 8 cores per virtual machine. How many virtual machines can we host on the rack?
Reasoning: Let's calculate step-by-step.
1. Total CPUs in the rack = 4 nodes * 2 CPUs/node = 8 CPUs.
2. Total cores in the rack = 8 CPUs * 16 cores/CPU = 128 cores.
3. Total virtual machines = 128 cores / 8 cores/VM = 16 VMs.
Answer: 16
Production Concerns සහ Trade-offs
විස්තරාත්මක prompts මගින් වඩා හොඳ ප්රතිඵල ලැබුණද, production පරිසරයකදී පහත කරුණු පිළිබඳව සැලකිලිමත් විය යුතුය:
- Token Latency: Prompts විශාල වන විට Time-to-First-Token (TTFT) සහ සමස්ත inference කාලය වැඩි වේ. මන්ද self-attention mechanism එක sequence length එක මත quadratically scale වන බැවිනි.
- Financial Cost: වාණිජමය LLM APIs සඳහා අය කරනු ලබන්නේ input සහ output token ප්රමාණය මතය. අනවශ්ය ලෙස දිගු prompts භාවිතය මගින් මෙහෙයුම් පිරිවැය (operational costs) විශාල ලෙස ඉහළ යා හැක.
- Context Window Degradation: නවීන models සතුව විශාල context windows පැවතුනද, දිගු prompts මැද ඇති තොරතුරු මග හැරීමේ ප්රවණතාවක් (lost in the middle phenomenon) පැවතිය හැක.
Conclusion
සාර්ථක prompt එකක් යනු හුදෙක් නිර්මාණාත්මක ලිවීමක් නොවේ; එය constraints සහ probability steering නිවැරදිව කළමනාකරණය කිරීමකි. පැහැදිලි system roles, explicit grounding data, වෙන් කර හඳුනාගත් payloads, සහ strict output constraints භාවිතයෙන් පද්ධති වඩාත් විශ්වසනීය සහ කාර්යක්ෂම ලෙස නිර්මාණය කිරීමට developer වරුන්ට හැකියාව ලැබේ.